

前幾天一路做到現在,我其實已經量了不少「可靠性」。
Day 1 先從最基本的 Accuracy 開始,Day 2 看同一題問多次會不會亂飄,Day 3 把 Accuracy 和 Consistency 放在一起,Day 4 開始要求輸出格式真的能進系統,Day 5 加入「不知道就不要亂答」的 Abstention,Day 6 再往前一步,用 confidence threshold 畫出 Risk-Coverage 的關係。
做到 Day 6 時,我原本直覺上會覺得:
既然 confidence 越高的答案通常越值得留下,那是不是代表 confidence 本身就可以相信?
但仔細想,其實完全不是同一件事。
一個模型可以很會「排序」哪些答案比較可靠,卻還是可能把自己的信心喊得太高。
例如它說:
這題我有 95% 把握。
真正的問題不是這個數字看起來高不高,而是:
如果它說了很多次 95%,這些答案真的大約有 95% 是對的嗎?
這就是今天要處理的問題:
Calibration,校準。
今天我刻意沒有直接接真正的 LLM API。
原因不是做不到,而是如果一開始就丟進真實模型,錯誤可能同時來自 prompt、資料集、模型本身、confidence 產生方式、評分器,最後很難知道我寫的 calibration evaluator 到底有沒有算對。
所以 Day 7 先做的是一個 controlled synthetic experiment。
也就是我自己建構兩組資料,讓它們:
Accuracy 完全一樣,但 confidence 行為故意不一樣。
第一組叫做:
matched_confidence
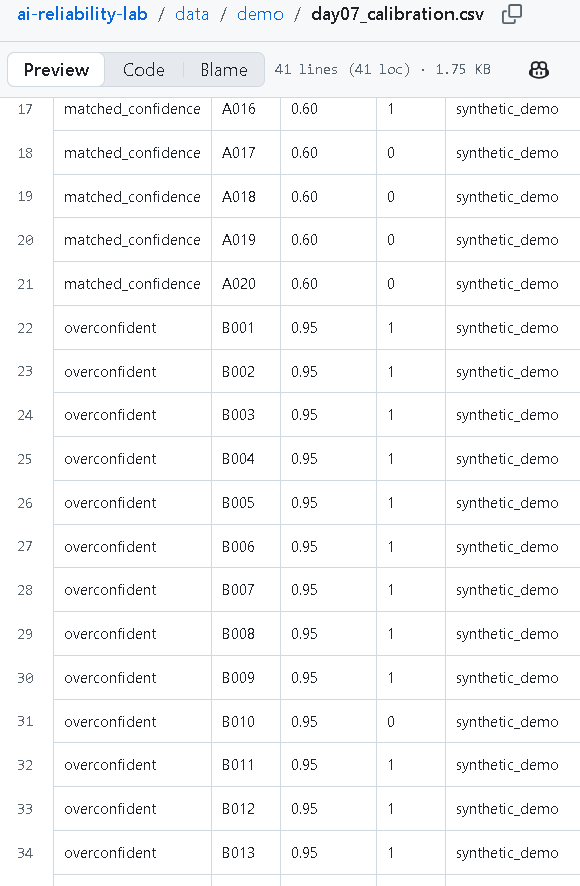
總共 20 筆。
其中 10 筆 confidence = 0.90,剛好 9 筆答對、1 筆答錯。
另外 10 筆 confidence = 0.60,剛好 6 筆答對、4 筆答錯。
所以整體正確率是:
Accuracy = 15 / 20 = 0.75
平均 confidence 剛好也是:
Mean Confidence
= (10 × 0.90 + 10 × 0.60) / 20
= 0.75
第二組叫做:
overconfident
我刻意保留完全相同的 20 個 correctness labels。
也就是答對、答錯的位置都沒有改。
唯一改變的是,全部都讓系統宣稱:
confidence = 0.95
因此它的 Accuracy 還是一樣:
Accuracy = 0.75
但是平均 confidence 變成:
Mean Confidence = 0.95
如果我今天只看 Accuracy,兩個系統完全沒有差別。
都是 75%。
可是第二個系統明明正在非常有自信地高估自己。
最簡單的做法,是先比較平均 confidence 和實際 accuracy。
我定義:
Confidence Gap = Mean Confidence - Accuracy
如果是正數,代表整體偏 overconfident。
如果是負數,代表整體偏 underconfident。
在第一組資料裡:
0.75 - 0.75 = 0
第二組則是:
0.95 - 0.75 = 0.20
光這裡其實已經可以看到問題。
但是只看平均值還是太粗。
因為兩組完全不同的 confidence 分布,有可能最後平均值剛好一樣。
所以接下來需要真的把「每筆 confidence 和 correctness 的距離」納入計算。
今天加入的第二個指標是 Brier Score。
對 binary correctness 而言,我使用:
Brier Score
= (1 / N) × Σ (confidence_i - correct_i)^2
其中:
confidence_i 是模型對第 i 筆答案的 confidencecorrect_i 則是答案是否正確這個公式有一個我很喜歡的特性:
越有自信地答錯,懲罰越大。
假設 confidence = 0.9,而且真的答對:
(0.9 - 1)^2 = 0.01
但如果一樣喊 0.9,結果卻答錯:
(0.9 - 0)^2 = 0.81
錯誤的代價直接差很多。
這和 AI 系統實際部署時的直覺很接近。
我其實不一定最怕模型說:
我只有 55% 確定。
然後答錯。
更危險的情況通常是:
我 99% 確定。
結果答案卻是錯的。
在今天的 synthetic experiment 裡,實際結果是:
| Scenario | Accuracy | Mean Confidence | Gap | Brier Score | ECE |
|---|---|---|---|---|---|
| matched_confidence | 0.75 | 0.75 | 0.00 | 0.1650 | 0.00 |
| overconfident | 0.75 | 0.95 | 0.20 | 0.2275 | 0.20 |
兩組 Accuracy 一模一樣。
但 Brier Score 從:
0.165
上升到:
0.2275
也就是第二組雖然「答對率完全沒有下降」,它提供的 probability quality 卻明顯變差了。
不過這裡也要特別小心一件事。
Brier Score 不等於純粹的 Calibration Error。
它是一個 probabilistic scoring rule,會同時受到 correctness 與 confidence quality 影響。
所以我不打算把 Brier Score 當成「唯一的校準分數」。
它比較像是今天 evaluator 裡的一個 complementary metric。
接下來才是今天最直接針對 Calibration 的指標:
Expected Calibration Error,ECE。
概念其實比名字簡單很多。
我先把 confidence 分成數個區間。
Day 7 暫時使用 5 個 equal-width bins:
[0.0, 0.2)
[0.2, 0.4)
[0.4, 0.6)
[0.6, 0.8)
[0.8, 1.0]
接著對每一個 bin 比較:
平均 confidence
和
實際 accuracy
兩者差多少。
最後再按照每個 bin 裡面的樣本數加權。
公式可以寫成:
ECE
= Σ (bin_count / N)
  × |empirical_accuracy - mean_confidence|
今天第一組資料會得到:
matched_confidence

[0.0, 0.2)
count = 0

[0.2, 0.4)
count = 0

[0.4, 0.6)
count = 0

[0.6, 0.8)
count = 10
mean confidence = 0.60
empirical accuracy = 0.60
absolute gap = 0.00

[0.8, 1.0]
count = 10
mean confidence = 0.90
empirical accuracy = 0.90
absolute gap = 0.00
所以在這個刻意控制的 synthetic construction 裡,兩個 confidence group 都剛好和 observed accuracy 對上。
因此:
ECE = 0.00
我要特別強調,這不代表:
這是一個現實世界中完美校準的 AI。
它只代表:
在我今天建構的 20 筆 synthetic samples,以及目前這個 5-bin 設定下,觀察到的 group frequency 正好吻合 confidence。
第二組就完全不一樣。
全部 20 筆都塞進最後一個 bin:
overconfident

[0.8, 1.0]
count = 20
mean confidence = 0.95
empirical accuracy = 0.75
absolute gap = 0.20
所以:
ECE = 0.20
這時兩組系統的差異終於很清楚了:
Accuracy
0.75 vs 0.75
但是:
ECE
0.00 vs 0.20
Accuracy 完全看不到的東西,被 Calibration 抓到了。
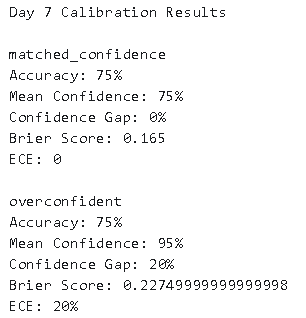
建議顯示兩組 Scenario 的 Accuracy、Mean Confidence、Brier Score 與 ECE。
正常談 Calibration,通常還會畫 Reliability Diagram。
橫軸放:
Mean Confidence
縱軸放:
Empirical Accuracy
如果 confidence 跟實際頻率對得越好,點就會越接近:
y = x
不過 Day 7 我刻意沒有急著加 matplotlib。
因為目前真正重要的不是「畫一張漂亮圖」,而是先確定底層資料結構正確。
所以 evaluator 現在會先輸出每個 bin 的:
lower_bound
upper_bound
count
mean_confidence
empirical_accuracy
absolute_gap
而且會直接存進 metrics.json。
例如 matched scenario 的其中一個 bin 會是類似:
{
  "lower_bound": 0.6,
  "upper_bound": 0.8,
  "count": 10,
  "mean_confidence": 0.6,
  "empirical_accuracy": 0.6,
  "absolute_gap": 0.0
}
這代表未來要做 dashboard、matplotlib、Streamlit 或 case viewer 時,不需要重新計算 calibration。
Visualization 可以只是 artifact 的 consumer。
這也是我現在慢慢在建立的架構原則:
Evaluation 負責算,Artifact 負責記,Reporting 負責顯示。
不要全部寫死在同一支 script 裡。
這也是今天和前幾天很不一樣的地方。
Day 1~Day 6 一開始都是一天一支比較獨立的小 evaluator。
但在進 Day 7 以前,我先把它們全部整理成 Foundation v1。
第一次整理完成後,測試有:
23 passed
後來再做一輪 semantic parity review,我才發現一件很有趣的事:
測試全部通過,不代表重構後的定義就真的完全一樣。
像 Day 2 Pairwise Jaccard 到底該使用 raw output 還是 normalized output、Day 3 是否要 lowercase、同一個 question 要用哪一個 expected、Day 5 的 Decision Accuracy 到底是在量「有沒有做對回答/拒答決策」,還是在量「答案內容本身對不對」。
這些差異在原本 demo data 上,不一定會直接讓數字改變。
最後我把這些 semantic drift 補成 regression tests,Foundation v1.1 來到:
30 passed
而今天 Calibration 並不是再新增一支:
day07.py
然後跑完就算了。
而是真的加入目前的專案架構:
src/ai_reliability/metrics/calibration.py
再由既有的 Runner 一起執行。
現在:
airlab run --mode demo --config configs/demo.json
一次就會計算 Day 1 到 Day 7。
而一個 run 仍然只產生同樣四種核心 artifacts:
metadata.json
records.jsonl
metrics.json
gate.json
Day 7 的 40 筆 synthetic records 會一起進入:
records.jsonl
Calibration 結果則會進入:
metrics.json
今天加入 Day 7 後,完整測試數量從 Foundation v1.1 的:
30 passed
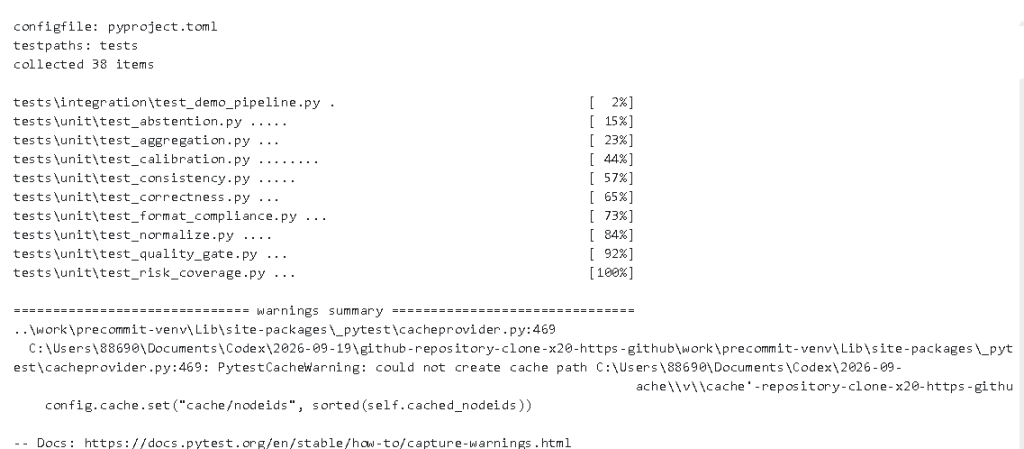
增加到:
38 passed
0 failed
而且 Day 1~Day 6 的 regression 結果全部維持不變。
這一點對我來說,甚至比今天算出:
ECE = 0.20
更重要。
因為 AI Engineering 如果每新增一個功能,就不小心把前面的 metric definition 改掉,那最後再多指標也沒有意義。
今天還有一個和 metric 本身無關,但對整個專案很重要的改變。
以前我寫完功能、測試通過後,大多就是直接留下程式。
但現在 GitHub 已經變成這個專案的 source of truth,所以 Day 7 我第一次正式把新功能放到:
day07-calibration-review
這個 branch。
實作完成後先跑:
38 passed
再把 branch push 到 GitHub 做 source-level review。
確認:
confidence = 1.0 能正確落在最後一個 bin確認完成後,才透過 fast-forward 合回 main。
最後 Day 7 的 commit 是:
397de45 Day 7: add synthetic calibration evaluation
這對我來說也是專案從「每天寫一支 Python」慢慢變成「真的在維護一個 AI Engineering system」的一個分界點。
目前整個 Demo Pipeline 的 Quality Gate 依然是:
BLOCK
但不是因為 Day 7。
目前 Gate 還是沿用前幾天留下來的兩個主要規則:
我今天沒有新增例如:
ECE <= 0.05 → PASS
ECE > 0.05 → BLOCK
因為現在如果這樣做,其實只是亂訂一個看起來很工程化的數字。
今天只有 20 筆 synthetic samples,而且 ECE 本來就會受到很多條件影響:
我現在沒有足夠的 real evidence 可以說:
ECE 超過多少就一定不能部署。
所以今天 Calibration 先停在:
Measurement
而不是:
Policy
我覺得這個差異非常重要。
Quality Gate 的 threshold 應該來自任務需求、風險容忍度和實際實驗,而不是因為程式裡需要一個數字,就隨便寫一個 0.1。
做到現在,我對「AI Reliability」的理解又往前推了一層。
一開始最直覺的問題是:
它答對了嗎?
後來發現還要問:
它每次都穩嗎?
再後來是:
不知道的時候,它願意停下來嗎?
Day 6 則變成:
只留下高 confidence 的答案,Risk 會不會下降?
但今天才真正補上下一個問題:
那個 confidence 本身,有資格叫 confidence 嗎?
如果一個系統 Accuracy 75%,每一題卻都聲稱自己有 95% 把握,單看 Accuracy 甚至看不出問題。
這也是今天 controlled experiment 最想證明的事情。
兩個 scenario:
Accuracy A = 0.75
Accuracy B = 0.75
但:
ECE A = 0.00
ECE B = 0.20
Accuracy 沒有變。
改變的是:
系統對自己有多了解。
而我開始覺得,這可能才是「可信任的 AI」很重要的一部分。
不是永遠不能犯錯。
而是它對自己「可能會錯」這件事,究竟有沒有概念。
今天所有 calibration 結果都必須加上一個大前提:
這是 Synthetic Controlled Demo。
0.90、0.60、0.95 這些 confidence 都是我刻意建構的數字。
它們不是:
所以也不能拿今天的:
ECE = 0.00
或:
ECE = 0.20
去宣稱哪個真實模型比較可靠。
而且目前 ECE 固定示範:
5 equal-width bins
不同 binning strategy、不同 sample size,最後數值都可能改變。
今天真正完成的是:
Calibration evaluator 本身的第一個可驗證版本。
還不是:
某個真實 AI 模型已經通過 Calibration Test。
這兩件事情我會繼續分得很清楚。
Day 7 把「校準的尺」先做出來了。
下一個問題就變得更麻煩:
LLM 的 confidence 到底要從哪裡來?
最直覺的方法可能是直接問模型:
請告訴我你有幾 % 把握。
但模型自己說:
95%
真的能直接當成 probability 嗎?
還是應該從:
去估計?
如果 confidence 的來源本身沒有意義,那後面再精密的 Calibration evaluator 也救不了它。
所以 Day 7 我先把尺做出來。
接下來,才是真正拿 AI 來量。


 iThome鐵人賽
 看影片追技術